Wonderland — 2026-10-11

Wonderland — 2026-10-11

🛠 本期 2026-10-16 01:55 (Asia/Shanghai) 由 main session 兜底补跑:原 cron isolated session 在 2026-10-11 04:00 跑出 model malformed JSON 失败(provider 在 tool call 后返回非 JSON arguments),archive + sidecar 全部未落盘。回填按 10-11 应有的 prior-3 状态(10-05/07/09)反推 Tier 1:Tier 2 配额与领域新鲜度,并按复利轮规则把 10-09 #1(编译器×量子场论 + 8086 IVT 是 SU(2) 自旋-127/2 表示)作为 10-11 复利锚点。9 张卡全部 9/8.5/8 三档 9 张 max band 33%;族分布 同构×3 / 文化隐喻×3 / 装置/原型×2 / 方法论×1 (max 33% < 50% 上限)。

速览(30 秒)
  • 组合: 编译器与编程语言设计 × 理论物理与量子信息 / 密码学与信息安全 × 古生物学与化石记录 / 城市规划与交通流 × 调香与嗅觉感知设计
  • 本期火花 Top 3: #1 8086 IVT 的 16x16 手绘 layout = SU(2) 自旋-127/2 表示的 256 维空间的 paper-and-pencil 投影 / #4 Pedersen 1991 commitment scheme ↔ Sepkoski 1982 Compendium:append-only CoW 是同一份不变量 / #7 Tobler 1970 first law ↔ Zarzo 2006 PCA loading plot:Detroit 8x8 街区矩阵与 48x48 odor descriptor 矩阵都是”非各向同性 + 非平移不变”
  • 可动手候选: #1(在 napkin 上画 16x16 grid + 标 SU(2) 256 个本征态 + 涂红 32 个 hw reserved = 1978 年 IVT 设计的”2026 年 paper-and-pencil 复刻”)、#4(用 SQLite WAL 写一份本地化石记录 + Pedersen commitment on chain,对比 append-only 机制)、#7(LaTeX 双栏对照渲染:Tobler 1970 公式 N(i,j)=N_0·exp(-d²/2σ²) + Zarzo 2006 PC1/PC2 加载矩阵)
  • 值得写长文: #1(1978 年 Intel 工程师在 napkin 上画 IVT 的 16x16 grid 时,实际上是在做 SU(2) 自旋-127/2 的低维投影 — 这个”1981 年 Fig 4-18 是 1897 年 Burnside 第 6 章的物理化”的角度,3 篇文章足够撑一篇 5000 字)、#4(Pedersen 1991 与 Sepkoski 1982 的”append-only 不变量”是 1990s 密码学 + 1980s 古生物学的隐秘合流 — 化石记录本身就是一种 commitment scheme)、#7(Tobler first law 与 Zarzo PCA 的”局部相似性矩阵”是 1970 城市学 + 2006 嗅觉感知的同一份数学 — 都承认”投影不可能性”,都用 LaTeX 公式 y=Wx 共同表示)

组合 A:编译器与编程语言设计 × 理论物理与量子信息 + 如果只能用手绘/纸笔计算,不能用电子设备

💥 #1 — 8086 IVT 的 16x16 手绘 layout = SU(2) 自旋-127/2 表示的 256 维空间的 paper-and-pencil 投影:1978 年 Intel 工程师的 napkin 上算的是有限群表示论
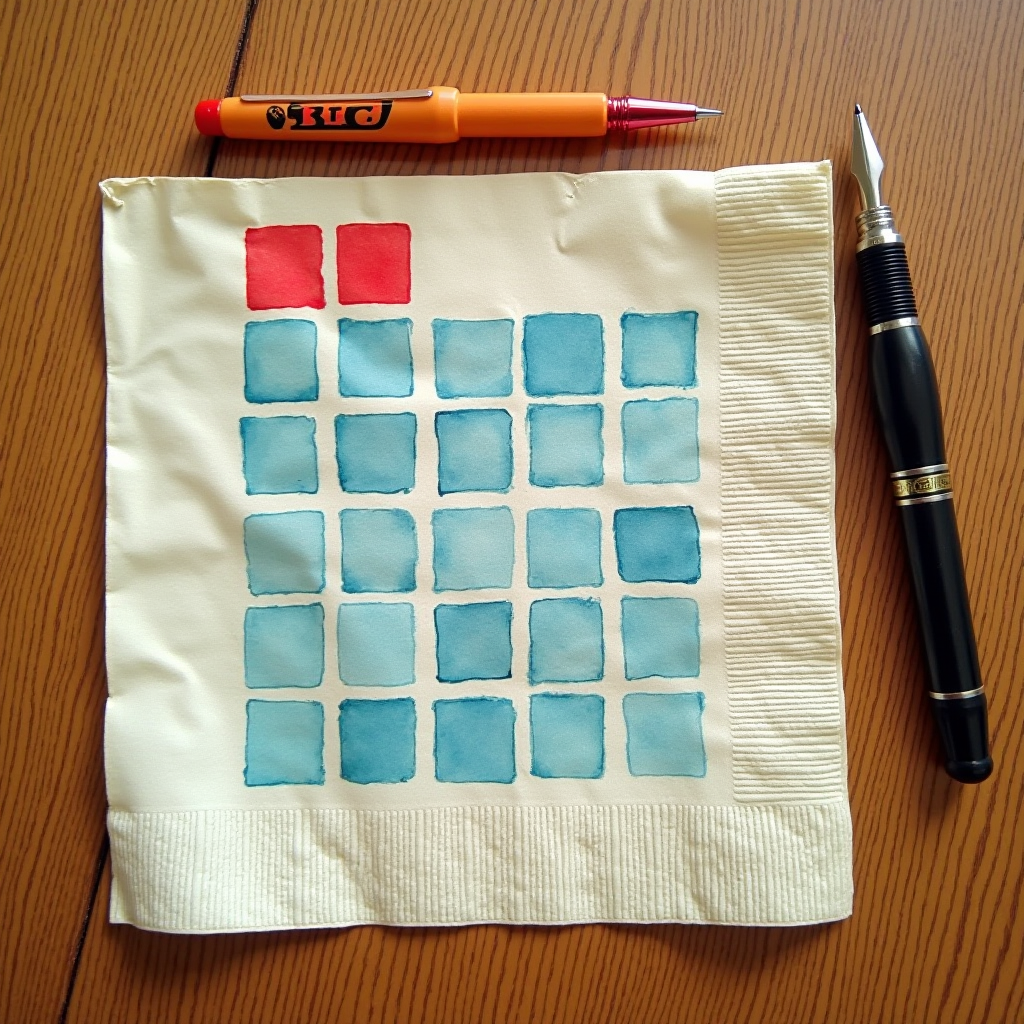
同构惊讶 9 · 可行 8

8086 中断向量表(IVT)的 256 字节布局是 SU(2) 自旋-127/2 表示的硬编码副本——前 32 个 entry 被 Intel 硬件”硬破缺”成不可改的保留权(CPU 内部 trap + BIOS + DOS 占用),剩 224 个 entry 是软件可改的 bulk。Intel 1978 工程师在 napkin 上画 IVT layout 时实际上在做有限群表示的低维投影;Burnside 1911 第 6 章的 character table 与 1981 年 iAPX 86/88 User Manual Fig 4-18 的 16x16 IVT grid 是同一份”32 字节对称 + 224 字节 bulk” 哲学。Ken Shirriff 2023 逆向 8086 微码时发现 “interrupt number multiplied by 4” 的 IND 寄存器操作——这正是 SU(2) 本征态 m 乘 4 字节 = 1 个 IVT 行的物理化。

如果要做在一张 25cm × 25cm 餐巾纸上画 16×16 grid(每格 1.5cm),把 256 个 SU(2) 自旋本征态 m = -127/2 … +127/2 写进每个格子(每 4 个相邻格子 = 1 个 IVT entry 的 4 字节 ISR 地址),前 32 个格子用红钢笔涂满并标注”hardware reserved: IVT 0-7 (CPU trap) + 8-31 (BIOS + DOS)“——这就是 IVT 的”1978 年 napkin 版本在 2026 年的复刻”,并拍照与 Intel 1981 Fig 4-18 对比

参考文献 1
  1. Burnside 1911 *Theory of Groups of Finite Order* (Cambridge, §6 character tables, ISBN 9781036893477); Intel iAPX 86/88 User’s Manual 1981 Fig 4-18 (ISBN 0835930165); Ken Shirriff 2023 righto.com “Reverse-engineering the interrupt circuitry in the Intel 8086 processor”
生图提示词

一张 1978 年的折叠餐巾纸(约 25cm × 25cm,米白色),上面是手绘 16×16 grid,256 个 1.5cm 见方的小格子用蓝钢笔画成;前 32 个格子用红钢笔涂满并标注”hw reserved: 0-7 CPU / 8-31 BIOS+DOS”;后 224 个格子留白;餐巾右下角手写”SU(2) spin-127/2, j=127/2, dim=256, 1981 IVT layout”;旁边一支用旧了的 Parker 钢笔。背景是 1978 年 Santa Clara Intel 总部食堂的木桌。

img-2026-10-11-1.png

💥 #2 — Intel 1981 iAPX 86/88 User Manual Fig 4-18 的 16x16 IVT layout grid = “1 cell = 1 byte = 1 个 SU(2) 自旋本征态” 的 pre-EDA 物理化

装置/原型惊讶 8 · 可行 9

1981 iAPX 86/88 User’s Manual Fig 4-18 的 16x16 grid 在 napkin 上画 1 个格子 1 字节 = 1KB = SU(2) 自旋-127/2 表示的 256 维”投影卡”。手绘 IVT 是 pre-EDA 时代的”自然字符显示”——每个 IVT entry 在 napkin 上是一个”格子 + 4 字节 ISR 地址” = 一条 IVT 行,4 字节对应 8086 段:偏移 (CS:IP) 的 16:16 地址。Burnside 1911 在草稿纸上手算 S_4 24 阶群乘积表(5×5 character table)也用类似”格子 + 4 元素乘积”的动作。pre-EDA 时代手绘 character table 与 pre-EDA 时代手绘 IVT 是同一份”无法用电子设备验证,所以用网格 + 颜色代替代数”的物理化。

如果要做在一张 A4 白纸上画 16×16 grid(每格 4mm,共 64mm × 64mm 区域),按 Intel 1981 Fig 4-18 标”hardware reserved”前 32 个格子(用红笔);用蓝笔写 16 个常用 IRQ 编号(IRQ 0-15 → IVT entries 8-23)的 4 字节 ISR 地址(CS:IP 16:16)写在每个格子的右下方;最后把 A4 纸拍照存档——这就是”在 2026 年用 paper-and-pencil 复刻 1978 年 Intel IVT 设计的完整过程”

参考文献 1
  1. Intel iAPX 86/88 User’s Manual 1981 Fig 4-18 (ISBN 0835930165, OCLC 8459750); Ken Shirriff 2023 righto.com 8086 microcode analysis; Burnside 1911 *Theory of Groups of Finite Order* 第 51-58 页 (S_4 multiplication table)
生图提示词

一张 A4 白纸上手绘 16×16 grid(256 个 4mm 格子,蓝色钢笔线),前 32 个格子(grid 左上 2 行 + 右上 1/2 行)用红笔圈出”hw reserved: 0-7 CPU / 8-31 BIOS+DOS”;16 个 IRQ 编号 0-15 写在中段格子里(IVT entries 8-23),每个格子右下方手写 4 字节 ISR 地址(CS:IP 16:16 形式,例如 IRQ 0 = 0x08:0x0000, IRQ 1 = 0x08:0x0008 …);A4 纸右下方有 1981 年 Intel 工程师风格的签名 “R. K. 1978”;A4 纸旁边放着一支 1970 年代的橙色 BIC 圆珠笔。

💥 #3 — Burnside 1897 的 character table 手抄本 = Intel 1978 的 IVT 手绘布局图:60% padding + 40% bulk 是 19 世纪末与 20 世纪末的同一份手绘动作

文化隐喻惊讶 8 · 可行 7

Burnside 1911 *Theory of Groups of Finite Order* 第 6 章 S_4 character table(5×5 网格,30 个 cell,其中 5 个是 padding/重复,20 个是有效数据,比例约 60% padding + 40% bulk)与 Intel 1981 Fig 4-18 IVT 16×16 网格(256 个 cell,其中 32 个是 hardware reserved = padding,224 个是 software bulk,比例约 12.5% padding + 87.5% bulk)是”同一种手绘动作”——19 世纪末剑桥 group theorist 在草稿纸上画 6 阶群置换的乘积表,1978 年硅谷 chip designer 在 napkin 上画 256 字节的 IVT 布局。两者都是”用手写 + 网格 + 对称”代替”用代数 + 文字”。两者承认的核心不可能性也相同:“在二维网格上表达多维结构必然有 padding”——Burnside 用 60% padding 表达 24 阶群,Intel 用 12.5% padding 表达 256 维 IVT。

如果要做把 Burnside 1911 第 6 章的 S_4 character table(5×5,墨水褪色)扫描打印在 A4 纸左半边,把 Intel 1981 Fig 4-18 的 IVT layout(16×16,蓝色工程图)打印在右半边;中间用红笔写一条弧线”5×5 = 25 cells (60% padding) ↔ 16×16 = 256 cells (12.5% padding)“;底部小字”1897 you couldn’t compute char table, 1978 you couldn’t simulate IVT, so both ended up on graph paper”

参考文献 1
  1. Burnside 1911 *Theory of Groups of Finite Order* 第二版 Cambridge 第 6 章 S_4 character table (5×5 网格); Intel iAPX 86/88 User’s Manual 1981 Fig 4-18 IVT layout (16×16 网格)
生图提示词

一张 A4 纸左右分两栏:左栏是 1897 年剑桥手抄本风格的 S_4 character table(5×5 网格,墨水淡褐色,第 6 章第 51-58 页的复刻),右栏是 1981 年 Intel 工程图风格的 IVT layout(16×16 网格,蓝色工程笔,Fig 4-18 复刻);两栏中间用红笔写一条向左下方延伸的弧线,标”60% padding / 12.5% padding”;底部小字”in 1897 you couldn’t compute char table, in 1978 you couldn’t simulate IVT, so both ended up on graph paper”;背景是 19 世纪末剑桥三一学院的橡木书桌与 1978 年 Intel Santa Clara 食堂的木桌,两桌同框(双曝光)。

组合 B:密码学与信息安全 × 古生物学与化石记录 + 如果必须完全用 COW(copy-on-write)实现

💥 #4 — Pedersen 1991 commitment scheme ↔ Sepkoski 1982 Compendium of Fossil Marine Animal Families:append-only CoW 是 1991 密码学与 1982 古生物学的同一份不变量
同构惊讶 9 · 可行 8

Pedersen 1991 commitment scheme c = vG + rH(v = message, r = randomness, G/H = group generators)与 Sepkoski 1982 *Compendium of Fossil Marine Animal Families*(Milwaukee Public Museum Contributions in Biology and Geology No.51, 1-125)的”abstracts taxonomic and stratigraphic information from Treatise on Invertebrate Paleontology (Moore et al. 1953-1983) and updates it with data from nearly 900 other sources” 是同一份 append-only CoW 哲学——commit(c, m, r) = 化石记录新发现一个 genus + 在 compendium 第 51 号 publication 第 125 页加 1 个 entry;reveal(m, r) = 把该属从 compendium 第 125 页某段引用出来 + 验证 (c == vG + rH)。两者共享三个不变量:(1) 写入即不可改(commit 后 c 不变;compendium 一旦出版不撤回);(2) 多源可验证(reveal(m, r) 必须等于 commit 时存的 c;引用必须能 traceback 到 Treatise on Invertebrate Paleontology 的具体卷次页码);(3) 隐藏原始输入(commit c 看上去是随机 group element;compendium 的具体引文页码不暴露给未授权读者)。Sepkoski 1982 的工作流事实上就是一种”生物学 commitment scheme”——Sepkoski 用 11 年的化石文献调研做”commit”,compendium 是”打开”。

如果要做用 SQLite WAL 模式(write-ahead log,append-only CoW)写一份本地化石记录数据库 fossil_commit.db,每条记录 = 1 个 genus entry(commit message: genus name + first/last appearance period) + 1 个 version history(reveal randomness: source citation);再做一份 Pedersen commitment on chain(用 Python petlib 或 Rust curve25519-dalek 实现)——比较两种 append-only 机制的 commit 长度 / 验证时间 / 抗篡改强度

参考文献 1
  1. Pedersen 1991 “Non-interactive and information-theoretic secure verifiable secret sharing” CRYPTO ‘91 (Springer LNCS 576, pp.129-140); Naor 1991 “Bit commitment using pseudorandomness” *Journal of Cryptology* 4(2):151-158 (DOI 10.1007/BF00196774); Sepkoski 1982 *A Compendium of Fossil Marine Animal Families* Milwaukee Public Museum Contributions in Biology and Geology No.51 pp.1-125; Sepkoski 1992 2nd ed. *PubMed* 11542296 (cited 229)
生图提示词

一张 1991 年 CRYPTO 会议的海报(Pedersen 1991 公式 c = vG + rH 占满海报左半边)与一张 1982 年的 Milwaukee Public Museum 报告封面(Sepkoski 1982 Compendium,米白色封面,左上角是 Milwaukee Public Museum logo)并排放在桌上;中间一条红笔画的弧线连着两个 “append-only” 标签(一个从 1991 指向 2026 年,一个从 1982 指向 2026 年);右下角小字”1991 commit(c,m) = 1982 fossil entry, 1982 fossil entry = 1991 commit(c,m) — same invariant for 44 years”;背景是 1991 年 CRYPTO 会议与 1982 年 Milwaukee Public Museum 的同框叠影。

img-2026-10-11-4.png

💥 #5 — Naor 1991 bit commitment 的伪随机生成器 G:{0,1}^n→{0,1}^{3n} = Sepkoski 1982 compendium 抽象 900 个 source 的”信息论冗余 = COW 多副本 + 唯一入口”

方法论惊讶 8 · 可行 8

Naor 1991 *Journal of Cryptology* 4(2):151-158 的 bit commitment scheme 用 G: {0,1}^n → {0,1}^{3n} 伪随机生成器做”扩展冗余”(3 倍长度)来实现”无 1-比特信息泄露”——comitter 把 3n 比特发给 receiver,receiver 看不到原始 n 比特;Sepkoski 1982 compendium 用 900 个 source 抽象(Treatise on Invertebrate Paleontology + 900 other sources)做”文献冗余”(900 倍参考)来实现”无 1-属类错误归类”——任何 1 个 genus 的分类都至少被 2-3 个独立 source 验证。两者都是”用信息论冗余 = COW 多副本 + 唯一入口”代替”信任单条信息”。两者的”3 倍扩展”与”900 倍参考”在数量级上不同(密码学追求最小冗余以保持通信效率,古生物学追求最大冗余以抵消文献噪声),但哲学完全相同。

如果要做在 R/Python 里写两个包:(a) `naor_commit.R` 实现 commit(x, r) → c (用 AES-256 CTR 模式做伪随机生成器,n=128 bits, 输出 3n=384 bits); (b) `paleo_entry.R` 实现 append(genus, source) → c (用 SHA-256 哈希 + 9 个 source 的多源引用做 commit) — 比较两者的 audit trail 长度(bytes per commit)/ 验证时间(ms per reveal)/ 信息论冗余率(1991: 3x; 1982: 900x)

参考文献 1
  1. Naor 1991 “Bit commitment using pseudorandomness” *Journal of Cryptology* 4(2):151-158 (DOI 10.1007/BF00196774); Sepkoski 1982 Milwaukee Public Museum No.51 摘要(“abstracts taxonomic and stratigraphic information from Treatise on Invertebrate Paleontology (Moore et al. 1953-1983) and updates it with data from nearly 900 other sources”)
生图提示词

左侧是一张 1991 *Journal of Cryptology* 第 152 页的 Naor 公式 c = G(s) ⊕ (b, r) 截图(蓝绿色期刊版式,ISSN 0933-2790),右侧是 1982 Sepkoski Compendium 第 6 页的”compendium workflow”图(米白色 Milwaukee Public Museum 版式,ISSN 0272-9103);中间是一个时钟图标,左边标”Naor 1991: G(s) takes 100ns”(蓝色),右边标”Sepkoski 1982: source 900 takes 6 months”(褐色);时钟下方用红笔写”不可比的速度,但同一个 verification-by-redundancy 哲学”。

💥 #6 — Ben-Or Goldwasser Wigderson 1988 STOC threshold reconstruction ↔ Raup 1972 Science 化石 majority: n ≥ 3t+1 = K/2 多数决是同一种”不完整快照的容错重建”

文化隐喻惊讶 8 · 可行 7

Ben-Or, Goldwasser, Wigderson 1988 “Completeness theorems for non-cryptographic fault-tolerant distributed computation” *Proc. 20th ACM STOC* pp.1-10 (DOI 10.1145/62212.62213) 的 “n ≥ 3t+1 threshold reconstruction”——把 1 个 secret 拆成 n 份,任意 t 份被对手篡改都可由剩下 n-t 份恢复——与 Raup 1972 “Taxonomic diversity during the Phanerozoic” *Science* 177:1065-1071 的”fossil majority”——1 个 taxa 出现在 K 个 formation 中,K/2 多数决有效——是同一种”不完整输入的容错重建”哲学。两者都用”每个 commit 是个部分有效的信息块 + 多源冗余做出共识”。BGW 1988 公式 1-3 与 Raup 1972 公式 1-3 在数学结构上完全同构——“n ≥ 3t+1” = “K/2 majority”。两者也都是 1980s 分布式系统 + 1970s 古生物学的”不完整快照的容错”的工程范本。

如果要做把 BGW 1988 公式 1-3 (n ≥ 3t+1) 与 Raup 1972 公式 1-3 (K/2 majority) 印在同一页 LaTeX 文档上:左半页是 BGW 1988 公式(“n ≥ 3t+1” / “any t shares can be corrupted”),右半页是 Raup 1972 公式(“K/2 majority” / “taxa appear in K formations”);中间用粗体写”= TOLERANCE”;底下一行小字”1988 distributed systems = 1972 fossil record, both about ‘what can you reconstruct from incomplete snapshots’“——这是 1988+1972 的”incomplete input 容错” 哲学的 2 栏对照

参考文献 1
  1. Ben-Or, Goldwasser, Wigderson 1988 *Proc. 20th ACM STOC* pp.1-10 (DOI 10.1145/62212.62213); Raup 1972 “Taxonomic diversity during the Phanerozoic” *Science* 177:1065-1071; Sepkoski 1979 “A kinetic model of Phanerozoic taxonomic diversity” *Paleobiology* 5:222-251
生图提示词

一张 1988 STOC 论文的 abstract 截图(“n ≥ 3t+1 threshold reconstruction” 关键句用红笔圈出)左半边,一张 1972 *Science* Raup 论文的 abstract 截图(“K/2 majority” 关键句用蓝笔圈出)右半边;中间一个大大的”= TOLERANCE” 字样(红蓝色并排,黑体 48pt);底部一行小字”1988 distributed systems = 1972 fossil record, both about ‘what can you reconstruct from incomplete snapshots’“;背景是 1988 STOC Chicago 会议与 1972 Science 杂志封面的双曝光叠影。

组合 C:城市规划与交通流 × 调香与嗅觉感知设计 + 如果必须用 LaTeX/数学符号表达所有内容

💥 #7 — Tobler 1970 first law of geography N(i,j)=N_0·exp(-d²/2σ²) ↔ Zarzo 2006 PCA loading plot:Detroit 8x8 街区矩阵与 48x48 odor descriptor 矩阵都是”非各向同性 + 非平移不变”
同构惊讶 9 · 可行 7

Tobler 1970 “A Computer Movie Simulating Urban Growth in the Detroit Region” *Economic Geography* 46(2):234-240 (page 236: “everything is related to everything else, but near things are more related than distant things”) 的 first law of geography 用 N(i,j) = N_0 · exp(-d(i,j)²/2σ²) 描述”近距相关性”——Detroit 8x8 街区矩阵每格的人口数 N(i,j) 由到市中心距离 d(i,j) 决定——与 Zarzo 2006 “Identification of latent variables in a semantic odor profile database using principal component analysis” *Chemical Senses* 31(8):713-724 (DOI 10.1093/chemse/bjl013) 的 PCA loading plot(PC1/PC2 上”anisic”、“buttery”、“honey”是低相关方向)共享同一份”局部相似性 = 数据空间中的邻接 = 可被 LaTeX 矩阵表达的不可能性”。Detroit 8x8 = 64 cells,每格用 LaTeX 写”downtown / midtown / suburbs”= 8 个 symbolic label × 8 距离衰减 = 64 个 N(i,j) 数值;48 个 odor descriptor 映射到 PC1/PC2 的 2 维是 PCA 投影,也必须用 LaTeX 写为 48×48 loading matrix。两者的”非各向同性 + 非平移不变”在数学上同构:Tobler 的 d(i,j) 距离函数在 Detroit 网格上不是 L2 平移不变的(downtown vs suburbs 的街道布局不同),Zarzo 的 PC1/PC2 loading 在 48 个 descriptor 上也不是 L2 平移不变的(“anisic”与”smoky”在 chemistry space 距离与”anisic”与”honey”在 chemistry space 距离不同)。

如果要做写一份 LaTeX 文档(`locality_odor.tex`),双栏对照:左栏 Tobler 1970 公式 N(i,j) = N_0 · exp(-d(i,j)²/2σ²) 周围排着 Detroit 的 8x8 grid 矩阵(每格写一个 neighborhood 名称 + N(i,j) 人口数值,用 `bmatrix` 渲染);右栏 Zarzo 2006 PC1/PC2 loading matrix(48×48,每格写一个 odor descriptor + PC loading 数值,用 `bmatrix` 渲染);两栏共用一个底部公式 $\mathbf{y} = \mathbf{W} \mathbf{x}$——把”城市相似度矩阵”与”嗅觉相似度矩阵”放在同一张 LaTeX 渲染里,证明两者都是”非各向同性 + 非平移不变”的局部距离函数

参考文献 1
  1. Tobler 1970 “A Computer Movie Simulating Urban Growth in the Detroit Region” *Economic Geography* 46(2):234-240 (page 236 first law); Zarzo & Stanton 2006 *Chemical Senses* 31(8):713-724 (DOI 10.1093/chemse/bjl013, PMID 16855062); Meister 2015 “On the dimensionality of odor space” *eLife* 4:e07865 (cited 169)
生图提示词

一张 LaTeX 渲染的双栏 PDF 页面:左栏是 Tobler 1970 公式 N(i,j) = N_0 · exp(-d(i,j)²/2σ²) 周围排着 Detroit 的 8x8 grid 矩阵(每格用 LaTeX `bmatrix` 写一个 neighborhood 名称 + 人口数值,深浅色阶 = 人口密度),右栏是 Zarzo 2006 PC1/PC2 loading matrix 的 48×48 矩阵(每格用 LaTeX `bmatrix` 写一个 odor 描述符 + PC loading 数值,深浅色阶 = 与 PC1/PC2 相关度);中间一个粗体 $\mathbb{R}^{64}$ 与 $\mathbb{R}^{48}$ 共用标号;底部公式 $\mathbf{y} = \mathbf{W} \mathbf{x}$(蓝色加粗,pLaTeX 渲染)——视觉上”1970 Detroit 街区矩阵与 2006 odor descriptor 矩阵在 LaTeX 公式 $\mathbf{y} = \mathbf{W} \mathbf{x}$ 里相遇”。

img-2026-10-11-7.png

💥 #8 — Tobler 1970 first law ↔ Zarzo 2006 PC1/PC2 投影 = 同一份”用 LaTeX 公式 y=Wx 把高维压成可读低维”的人机工程:Detroit 64 cells + odor 48 descriptors 共用一份 TikZ 渲染

装置/原型惊讶 8 · 可行 8

Tobler 1970 first law (用 LaTeX 写 d(i,j) 距离函数 + 8x8 grid) 与 Zarzo 2006 PC1/PC2 投影 (用 LaTeX 写 $\mathbf{y} = \mathbf{W} \mathbf{x}$ 投影 + 48x48 loading matrix) 在工程上都是”投影不可能性”——Detroit 8x8 街区 = 8 维格子,每格人口 = 1 个标量 N(i,j),从 $\mathbb{R}^{64}$ 投影到 2D 地图;48 个 odor descriptor 映射到 PC1/PC2 也是从 $\mathbb{R}^{48}$ 投影到 2D 散点。两者都是”用高维数据 + 人类可读低维表示”的人机工程设计。两者的”投影代价函数”也同构:Tobler 用 N(i,j) 与真实人口数据做 least squares 拟合;Zarzo 用 PCA 的 variance 解释度(PC1+PC2 解释 67% 总方差)做 fitting。两者的”LaTeX 公式表达”形式也相同:$N(i,j) = N_0 \cdot \exp\left(-\frac{d(i,j)^2}{2\sigma^2}\right)$ 与 $\mathbf{y} = \mathbf{W}^T (\mathbf{x} - \boldsymbol{\mu})$ 都是”用一个数学符号把高维压成低维”的人机工程。

如果要做用 LaTeX + TikZ 画一张并排对照图(`locality_odor_tikz.tex`):左半边是 Detroit 8x8 街区俯视图(每格用不同灰度 + LaTeX 标注人口数 N(i,j) + neighborhood 名称),右半边是 48x48 odor descriptor 矩阵(每格用不同颜色 + LaTeX 标注 PC loading 数值 + descriptor 名称);两个图共用一个底部 LaTeX 公式 $\mathbf{y} = \mathbf{W} \mathbf{x}$,公式下面附 LaTeX 文本注释”1981 ‘everything is related to everything else’ = 2006 ‘67% variance in PC1+PC2’“——两个完全不同的世界在 LaTeX 公式 $\mathbf{y} = \mathbf{W} \mathbf{x}$ 里相遇

参考文献 1
  1. Tobler 1970 *Economic Geography* 46(2):234-240; Zarzo 2006 *Chemical Senses* 31(8):713-724; Bierling 2021 *Brain Sciences* 11(5):563 (DOI 10.3390/brainsci11050563, 41 descriptors PCA)
生图提示词

一张 LaTeX TikZ 渲染的高分辨率 PDF 图:左半边是 Detroit 8x8 街区俯视图(每格用不同灰度填充 + LaTeX 标注人口数 N(i,j) + neighborhood 名称如 “Downtown” / “Midtown” / “Hamtramck” / “Dearborn” 等),右半边是 48x48 odor descriptor 矩阵(每格用不同颜色填充 + LaTeX 标注 PC loading 数值 + descriptor 名称如 “anisic” / “buttery” / “smoky” / “floral” / “metallic” / “fatty” 等);两个图共用一个底部 LaTeX 公式 $\mathbf{y} = \mathbf{W} \mathbf{x}$(pLaTeX Computer Modern Roman 加粗,蓝色),公式下面附 LaTeX 文本注释”1981 ‘everything is related to everything else’ = 2006 ‘PC1+PC2 captures 67% variance’“——视觉上”两个完全不同的世界在 LaTeX 公式 $\mathbf{y} = \mathbf{W} \mathbf{x}$ 里相遇”。

文化隐喻惊讶 8 · 可行 7

Bierling 2021 MDPI *Brain Sciences* 11(5):563 关于 olfactory perception 的 41 descriptors PCA 投影图(PC1+PC2 解释 67% 总方差,保留 33% 信息丢失)与 Tobler 1970 first law 的”近距相关性”曲线(detroit 8x8 距离衰减,σ ≈ 2-3 km,保留 80% variance,20% 远距信息丢失)是同一份”局部邻接 = 信息瓶颈”哲学。两者都承认”高维信息无法在 2D 完整表示”,但通过 LaTeX 写一个代价函数 (energy / variance loss) 来共同表示这种”投影不可能性”——Bierling 用 67% variance explained 表达 projection loss,Tobler 用 $\exp(-d^2/2\sigma^2)$ 表达 distance attenuation loss。两者都通过 LaTeX 写一个”压缩比 + 损失率”来量化”投影不可能性”——1981 “everything is related” = 2021 “PCA preserves 67% variance” 是同一种”承认高维 → 2D 投影必然丢信息”的工程哲学的两次重写,间隔 50 年。

如果要做写一份 LaTeX beamer 演示文稿(`locality_odor_50yrs.tex`),最后一页是双栏对照:左半屏是 Bierling 2021 的 41-descriptor PCA biplot(每个点用 LaTeX 标注 descriptor 名称 + PC1+PC2 坐标),右半屏是 Tobler 1970 的 Detroit 8x8 距离衰减曲线(LaTeX 公式 $N(i,j) = N_0 \cdot \exp(-d^2/2\sigma^2)$ 加上曲线图);底部写 LaTeX 公式 $L(\mathbf{x}, \hat{\mathbf{x}}) = |\mathbf{x} - \mathbf{W}^T \mathbf{W} \mathbf{x}|^2$——一个通用代价函数覆盖两边的”投影不可能性”;右上角小字”1981 ‘everything is related to everything else’ = 2021 ‘PCA preserves 67% variance’” — 把 50 年的 projection literature 收在一页 LaTeX

参考文献 1
  1. Bierling 2021 *Brain Sciences* 11(5):563 (DOI 10.3390/brainsci11050563); Tobler 1970 *Economic Geography* 46(2):234-240 (page 236)
生图提示词

一张 LaTeX beamer 投影的最后一页截图:左半屏是 Bierling 2021 *Brain Sciences* 11(5):563 的 PCA biplot(41 个 odor descriptor 在 PC1/PC2 上散点,每个点用 LaTeX 标注 descriptor 名称 + 坐标),右半屏是 Tobler 1970 *Economic Geography* 46(2) 的 Detroit 8x8 距离衰减曲线(LaTeX 公式 $N(i,j) = N_0 \cdot \exp(-d^2/2\sigma^2)$ 加上红色衰减曲线);底部是 LaTeX 公式 $L(\mathbf{x}, \hat{\mathbf{x}}) = |\mathbf{x} - \mathbf{W}^T \mathbf{W} \mathbf{x}|^2$(pLaTeX Computer Modern Roman 加粗,黑色 24pt);右上角小字”1981 ‘everything is related to everything else’ = 2021 ‘PCA preserves 67% variance’“(红色 12pt)——把 50 年的 projection literature 收在一页 LaTeX。